2026 年 11 月的 MedBench 榜单上,iMed-6_Thoth 以 64.4 分的综合得分居首,DeepSeek-V4-Pro 为 64.0 分;在医疗原子技能维度,Gemini-3.1-Pro 拿到 75.9 分。
头部模型的分数如此接近,说明一件事:单靠“多背医学知识”已经拉不开差距,评测的重心正在转移。
一、榜单在测什么
MedBench 的评测维度通常包括医学知识、临床推理、多模态理解与安全合规。不同维度的权重变化,会直接改变排名。
过去两年,权重明显从“知识问答”移向“推理与任务”。原因很现实:知识可以查,推理与执行才是临床真正需要的。
不同榜单的权重差异很大:有的偏知识覆盖,有的偏推理链,有的偏多模态。看榜时先看权重,再看排名,否则很容易被一个总分误导。
二、分数接近说明什么
第一,基础能力已经趋于同质化。头部模型在常见题上的表现差异很小,竞争进入细节阶段。
第二,评测本身开始成为瓶颈。题目越难,越容易出现标注争议;题目越简单,越区分不出模型。
第三,真正的差距在场景里,而不在榜单上。一个在榜单上排第五的模型,可能在某个专科的真实任务中表现最好。
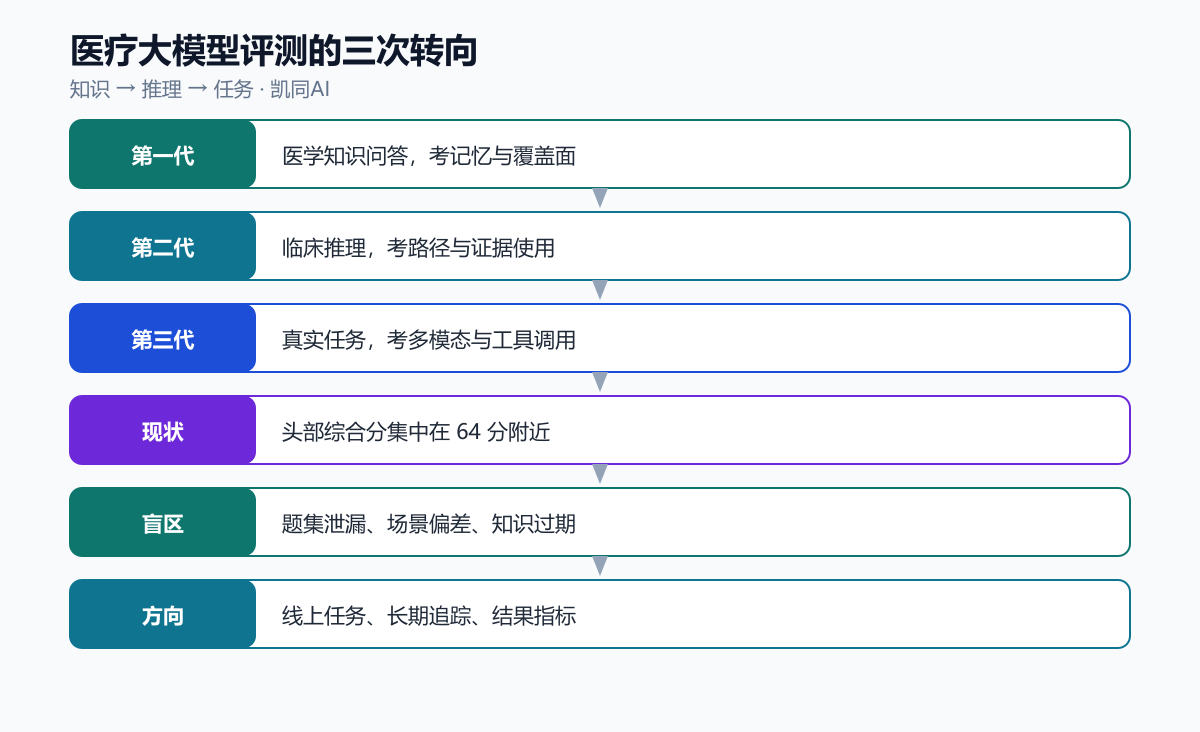
分数集中还有另一个原因:公开题集的泄漏风险。模型见过类似的题,分数就会虚高。这也是为什么头部团队越来越看重“私有测试集”与“线上真实任务”的表现。
三、从考试到干活
医疗AI的评测正在经历三次转向:从知识问答,到临床推理,再到真实任务执行。
真实任务包括:读一份带噪声的化验单、在电子病历里找到关键病史、判断是否需要转诊、生成一份可读的随访计划。这些任务没有标准答案,只有“合不合格”。
这也是为什么越来越多机构开始自建评测集。京东联合上海人工智能实验室共建 MedBench v5,就是把自己的场景经验变成标准的一部分。
多模态是分水岭。文本问答可以靠语料堆出来,影像、报告、语音则需要真正的跨模态对齐能力。医疗场景里,一张片子、一张化验单,往往比一段描述更有信息量。
四、评测的三个盲区
第一个盲区是题集泄漏。公开题目被模型见过,分数就会虚高,这是所有榜单的共同难题。
第二个盲区是场景偏差。榜单题多来自教科书与考试,真实临床充满模糊信息、缺失数据与患者主诉偏差。
第三个盲区是知识过期。医学指南每年更新,一次性评测无法反映模型今天的水平。
评测的第三个盲区是“时间”。医学知识每年更新,指南会改版,药品说明会修订。一个今天考 90 分的模型,半年后可能已经在用过期知识。持续评测比一次性榜单更重要。
五、企业采购为什么看榜
对医院与企业来说,榜单是降低决策成本的工具。它们没有能力自己评测十几个模型,只能借助第三方榜单做初筛。
但真正签约前,采购方一定会做场景测试:拿自己的真实病例跑一遍,看输出能不能用。榜单决定“进不进候选”,场景测试决定“签不签合同”。
采购方最常问的三个问题是:数据从哪来、更新频率如何、出了问题谁负责。这三个问题没有标准答案,却能把大部分演示型产品筛掉。
六、凯同怎么看评测
凯同AI不参与基座模型竞赛,但我们高度关注评测,因为它决定了合作方对“能力”的预期。
我们更看重另一类指标:方案执行率、随访完成率、指标改善幅度。这些指标不在任何榜单上,却直接决定用户是否续费。
换句话说,榜单测的是模型有多聪明,凯同要证明的是服务有多有效。两者不能互相替代。
凯同内部有一套自己的评测表:方案是否可执行、用户是否照做、四周后指标有没有变化、异常有没有被及时升级。这套表不好看,但能直接预测续费。
七、判断
未来一年,医疗大模型的榜单分数会继续挤在很小的区间里,排名变化的新闻价值会下降。
真正的竞争会转向三个地方:真实任务的表现、长期知识的更新、以及模型之外的服务闭环。谁能把这三件事做好,谁就不需要靠榜单证明自己。
参考资料
免责声明:本文为行业观察与信息交流,不构成医疗建议、诊断或治疗方案,也不构成投资建议。文中涉及的疾病、用药、检查与营养方案,请遵医嘱;如有不适或急症,请及时就医。文中数据与观点来自公开信息,仅供参考。